
YAPAY ZEKÂ NASIL ÇALIŞIR? AI'ın Karar Verme Süreci ve Güvenilirlik
Yapay zekâ sistemleri verilerden örüntüler öğrenerek yeni girdiler için tahmin ve kararlar üretir. sadece yüksek doğruluk koşullarda güvenilebileceğini açıklıyor.
1. Yapay zekâ nasıl çalışır?
Yapay zekâ tek bir algoritma değildir. Arama yöntemleri, kural tabanlı uzman sistemler, bulanık mantık, doğal dil işleme, makine öğrenmesi ve sinir ağları gibi farklı yaklaşımları kapsayan geniş bir alandır. Yüklenen temel AI ve robotik rehberi, bu alanı ajanlar, arama, uzman sistemler, doğal dil işleme ve yapay sinir ağları üzerinden tanıtır. Günümüzde ise özellikle görüntü, ses ve dil gibi karmaşık verilerde makine öğrenmesi ve derin öğrenme yaklaşımları belirleyici hale gelmiştir.
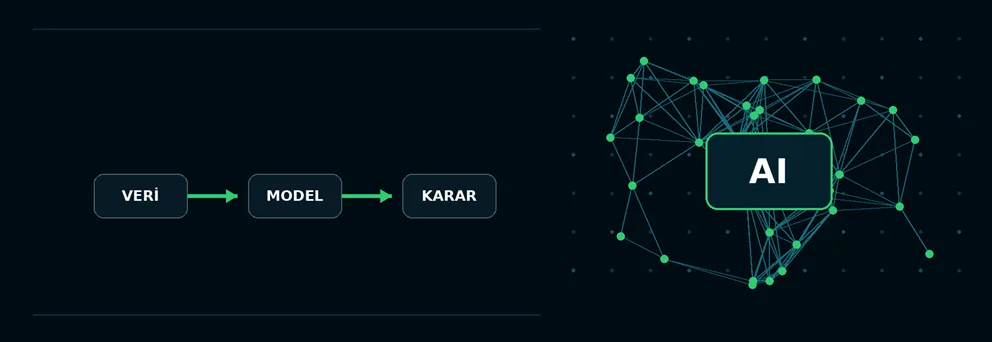
Klasik programlamada geliştirici kuralları açık biçimde yazar: veri ve kurallar birlikte işlenir ve sonuç elde edilir. Makine öğrenmesinde ise sistem, örnek veriler ve hedef çıktılar arasındaki ilişkilerden kuralları doğrudan kendisi öğrenir. Avrupa Komisyonu JRC raporu bu dönüşümü “sistemin programlanması” yerine “sistemin eğitilmesi” olarak özetler. Derin öğrenmede öğrenilen kurallar, sinir ağındaki çok sayıdaki ağırlık parametresinde saklanır.
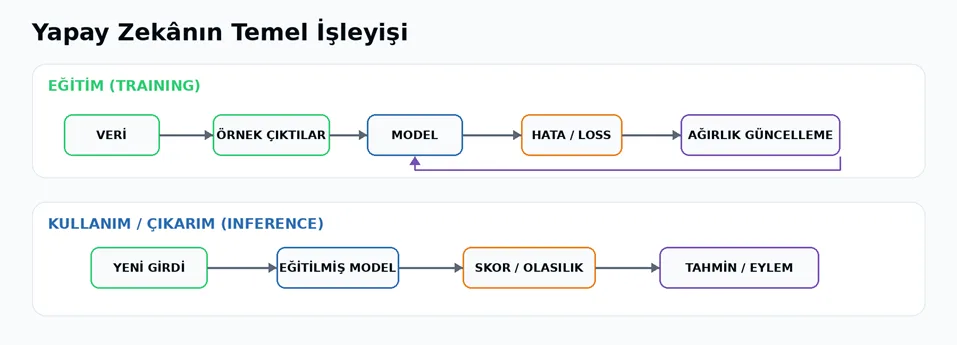
Şekil 1. Eğitim ve çıkarım aşamalarının sadeleştirilmiş gösterimi. Kaynak çerçevesi: JRC (2020) ve An et al. (2025); yeniden çizim.
1.1. Eğitim: Model neyi öğreniyor?
Bir modelin eğitimi sırasında başlangıçta ağırlıklar çoğu zaman rastgele veya belirli bir başlangıç yöntemiyle atanır. Model örnek veri üzerinden tahmin üretir; bu tahmin gerçek hedefle karşılaştırılır ve bir hata (loss) değeri hesaplanır. Ardından optimizasyon algoritması, hatayı azaltacak yönde ağırlıkları günceller. An ve arkadaşlarının 2025 tarihli oculomics incelemesi, derin öğrenme modellerinin bu süreci istatistiksel optimizasyon ve gradyanlar yoluyla gerçekleştirdiğini açıklar: tahmin iyileştikçe ağırlıklar tekrar tekrar ayarlanır ve performans artık anlamlı biçimde gelişmediğinde eğitim sonlandırılır.
Bu nedenle “AI öğrendi” ifadesi, insan benzeri bir bilinç oluştuğu anlamına gelmez. Teknik olarak olan şey, modelin girdi ile hedef arasındaki ilişkiyi temsil eden parametreleri hata fonksiyonunu azaltacak biçimde ayarlamasıdır.
1.2. Çıkarım: Eğitilen model yeni veride ne yapıyor?
Eğitim tamamlandığında model yeni bir girdiyle karşılaşır. Görüntü, metin, sensör ölçümü veya sayısal veri modelden geçirilir ve model bir sınıf, skor, olasılık ya da sayısal tahmin üretir. Bu aşamaya inference, yani çıkarım denir. Örneğin bir görüntü modeli “risk olasılığı 0,82” gibi bir çıktı verebilir. Nihai eylem ise modelin çıktısına, uygulama tasarımına ve varsa insan denetimine bağlıdır.
Önemli ayrım: AI çoğu uygulamada “karar” vermeden önce bir tahmin veya skor üretir. Bu skorun hangi eşiğin üzerinde eyleme dönüşeceği çoğu zaman sistem tasarımının ayrı bir parçasıdır.
2. AI karar verme süreci nasıl ilerler?
Derin öğrenme sistemlerinde karar süreci, özellikle dışarıdan bakıldığında tek adım gibi görünür: girdiyi ver, sonucu al. Modelin içinde ise veri katmanlar boyunca dönüştürülür. Convolutional neural network (CNN) gibi mimarilerde ilk katmanlar görüntüdeki daha basit örüntüleri filtreler; sonraki katmanlar bu temsilleri birleştirerek giderek daha soyut özellikler oluşturur. Son aşamada bu özellikler bir tahmin katmanında bir araya getirilir.
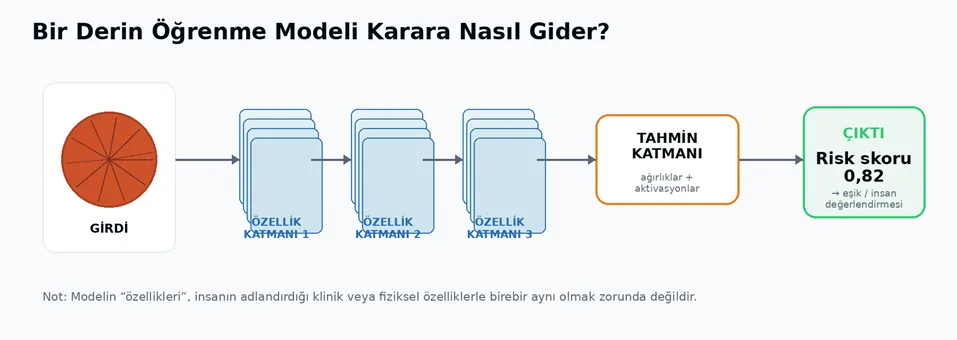
Şekil 2. Bir derin öğrenme modelinde girdiden skora uzanan karar yolu. Oculomics örneğindeki CNN açıklamasından uyarlanmıştır; yeniden çizim.
Buradaki kritik nokta, modelin öğrendiği özelliklerin her zaman insanın doğrudan isimlendirebildiği kavramlara karşılık gelmemesidir. An et al. çalışması bunu retina görüntüleri üzerinden gösterir: model damar dallanması, genel bulanıklık, kontrast değişimleri ve başka örüntüleri çeşitli kombinasyonlarda kullanabilir. Bu kombinasyonlar klinisyenin bildiği tek bir “biyobelirteç” ile birebir eşleşmeyebilir.
2.1. Skor, olasılık ve eşik
Bir sınıflandırma modelinin çıktısı çoğu zaman “evet/hayır” biçiminde doğrudan bir hüküm değildir. Sistem önce belirli sınıflar için olasılık veya skor üretir. Örneğin 0,82 risk skoru, tasarım gereği 0,70 eşiğinin üzerindeyse “yüksek risk” olarak işaretlenebilir. Eşik değeri değiştirildiğinde sistemin hassasiyeti ve yanlış alarm davranışı da değişir. Bu yüzden AI kararını değerlendirirken yalnızca model mimarisine değil, skorların nasıl yorumlandığına da bakmak gerekir.
2.2. Öğrenme türleri karar mantığını değiştirir
· Denetimli öğrenme (supervised learning): Model, doğru cevapları bilinen örneklerden öğrenir ve kendi tahminiyle hedef arasındaki hatayı azaltmaya çalışır.
· Denetimsiz öğrenme (unsupervised learning): Önceden verilmiş doğru etiket olmadan veri içindeki yapıları, kümeleri veya örüntüleri bulmaya çalışır.
· Pekiştirmeli öğrenme (reinforcement learning): Ajan, ortamda yaptığı eylemler sonucunda aldığı ödül veya ceza sinyallerinden davranış stratejisini geliştirir.
Bu üç yaklaşım temel rehberde de ayrı öğrenme stratejileri olarak ele alınır. Modern sistemlerde bunların farklı varyasyonları ve kombinasyonları kullanılabilir; ancak ortak fikir, karar mekanizmasının veri veya deneyimden türetilmesidir.
3. AI neden “kara kutu” gibi görünebilir?
Basit doğrusal modellerde bir girdinin sonuca katkısını takip etmek görece kolaydır. Ancak derin sinir ağları çok sayıda doğrusal ve doğrusal olmayan işlemi art arda uygular. Sonuç, tek bir değişkenin tek bir katsayıyla açıklanabildiği basit bir denklemden çok daha karmaşık hale gelir. Bu nedenle yüksek performanslı bir modelin hangi özelliği, hangi ara temsil üzerinden ve ne ölçüde kullandığını açıklamak zor olabilir.
Bu sorun özellikle yüksek riskli alanlarda önem kazanır. Oculomics makalesindeki örnekte bir retina AI sistemi, yalnızca göz hastalığını sınıflandırmak yerine yaş, tansiyon veya sistemik hastalık riski gibi doğrudan gözle görülmeyen sonuçları tahmin edebilir. Doktorun modelin sonucunu gözle denetlemesi bu nedenle çok daha zordur. Makale, nüfus seviyesindeki doğruluk metriklerinin tek bir birey için sonucun güvenilir olduğunu göstermeye yetmeyebileceğini özellikle vurgular.
4. Explainable AI ve Interpretable AI: Aynı şey değiller
An et al. iki kavram arasında önemli bir ayrım yapar. Explainable AI (xAI), yapay zekâ sisteminin bütünsel olarak nasıl sonuca ulaştığını; kullanım bağlamını, beklenen etkileri ve olası önyargıları da kapsayacak biçimde ele alır. Interpretable AI (iAI) ise daha dar bir alana odaklanır: çekirdek algoritmanın belirli bir tahmine nasıl ulaştığını anlamaya çalışır.
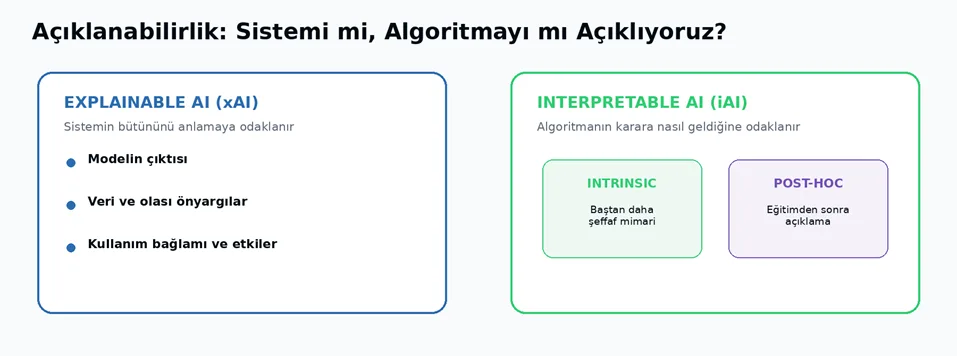
Şekil 3. Explainable AI ile Interpretable AI arasındaki kapsam farkı ve iAI içindeki intrinsic / post-hoc ayrımı. Kaynak: An et al. (2025); yeniden çizim.
Yorumlanabilirlik yöntemleri de iki ana gruba ayrılır. Intrinsic yöntemler, modelin mimarisini baştan daha şeffaf olacak biçimde tasarlar. Post-hoc yöntemler ise model eğitildikten sonra davranışını açıklamaya çalışır. Retina AI literatüründe post-hoc yöntemlerin, özellikle class activation map (CAM) ve GradCAM türlerinin daha yaygın olduğu görülür.
4.1. Heatmap bize ne söyler, ne söylemez?
GradCAM ve benzeri yöntemler, modelin görüntünün hangi bölgelerine daha fazla dikkat ettiğini bir ısı haritası üzerinde gösterebilir. Bu görseller kullanıcı açısından sezgisel görünür. Fakat makalenin temel uyarısı şudur: bir bölgenin vurgulanması, modelin o bölgede hangi özelliği kullandığını veya bu özelliği sonuca nasıl dönüştürdüğünü tek başına açıklamaz. Benzer görüntülerde farklı tekniklerin farklı alanları vurgulayabilmesi de yorumun istikrarını sınırlayabilir.
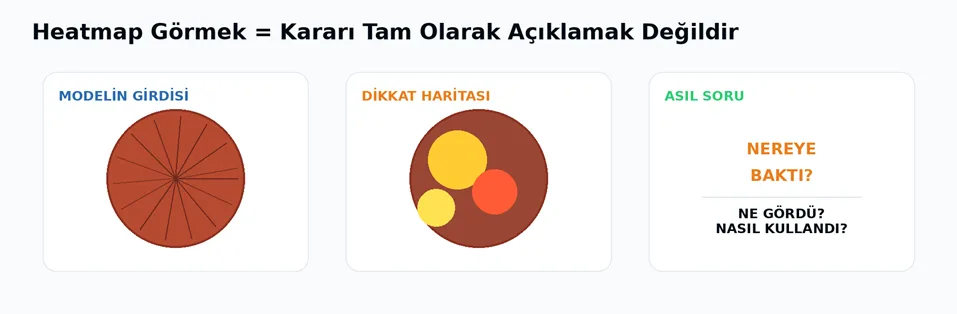
Şekil 4. Isı haritası, “nereye bakıldı?” sorusuna yardımcı olabilir; “ne görüldü ve nasıl kullanıldı?” sorularını tek başına çözmez. An et al. (2025) tartışmasından uyarlanmıştır.
5. Peki AI güvenilir mi?
Bir AI sistemine “güvenilir” demek için yalnızca test setindeki doğruluk oranına bakmak yeterli değildir. Güvenilirlik, modelin ne kadar doğru olduğunun yanı sıra farklı veri gruplarında nasıl davrandığı, tahmin olasılıklarının gerçekle ne kadar uyumlu olduğu, küçük değişikliklere karşı ne kadar dayanıklı olduğu, açıklanabilirliği ve gerektiğinde insan tarafından denetlenebilmesi gibi birden fazla boyutu içerir.
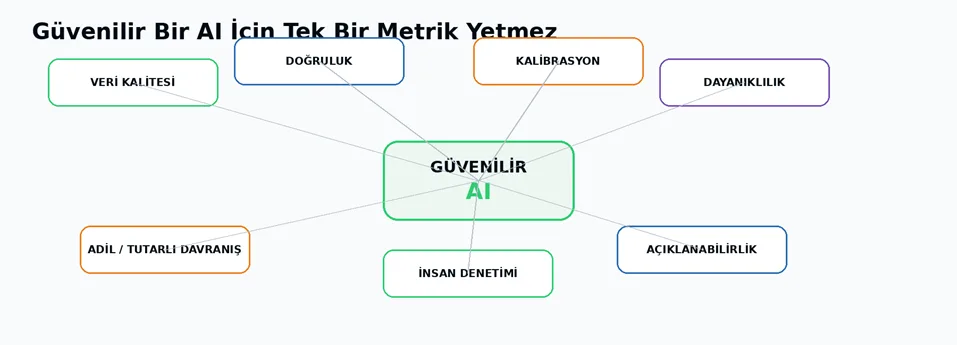
Şekil 5. Güvenilir AI değerlendirmesinde birlikte düşünülmesi gereken başlıca boyutlar. Kaynakların güven, kalibrasyon, veri yanlılığı ve insan denetimi tartışmalarından sentezlenmiştir.
5.1. Doğruluk tek başına neden yetmez?
Bir model genel olarak yüksek doğruluk gösterebilir fakat bazı alt gruplarda daha fazla hata yapabilir. Eğitim verisi belirli demografik grupları, cihazları veya kullanım koşullarını yeterince temsil etmiyorsa model gerçek dünyada beklenenden farklı davranabilir. Oculomics makalesi, retina veri setlerinin bazı hasta gruplarında yoğunlaşmasının genel popülasyona taşındığında güvenilirlik soruları doğurabileceğini belirtir.
5.2. Kalibrasyon: “%80” gerçekten %80 mi?
Kalibrasyon, modelin verdiği olasılıkların gerçek dünya frekanslarıyla ne kadar uyumlu olduğunu sorgular. Örneğin sistem benzer 100 vakaya yaklaşık %80 risk veriyorsa, bunların gerçekten yaklaşık 80’inde olay görülmesi beklenir. Bir model sınıfları iyi ayırabilir ancak olasılıkları kötü kalibre edilmiş olabilir. An et al., özellikle bireysel güven açısından yalnızca accuracy, sensitivity, specificity ve AUC gibi ayrım metriklerinin yeterli olmayabileceğini vurgular.
5.3. Bias ve veri temsili
Modelin öğrendiği şey, kullanılan veriden bağımsız değildir. Veri eksik, dengesiz veya belirli gruplara aşırı ağırlık veriyorsa sistemin tahminleri de bu yapıyı taşıyabilir. Bu yüzden “algoritma tarafsızdır” varsayımı güvenilir bir başlangıç noktası değildir; veri üretim sürecinin, etiketlerin ve uygulama bağlamının ayrıca incelenmesi gerekir.
5.4. İnsan denetimi
Yüksek etkili kararlarda AI çıktısının insan değerlendirmesiyle birleştirilmesi, özellikle modelin yeni veya olağandışı bir durumla karşılaştığı anlarda kritik olabilir. Burada amaç AI’yı değersizleştirmek değil; sistemin güçlü olduğu alanlarla insanın bağlam, sorumluluk ve istisna yönetimi kapasitesini doğru biçimde bir araya getirmektir.
6. Bir örnek: Retina görüntüsünden sistemik risk tahmini
Oculomics, bu tartışmayı somutlaştırmak için güçlü bir örnektir. Geleneksel retina hastalığı sınıflandırmasında bir model belirgin lezyonları arayabilir ve deneyimli klinisyen çıktıyı görüntü üzerinde kontrol edebilir. Sistemik hastalık tahmininde ise model, klinisyenin doğrudan tanımlayamadığı veya birden fazla özelliğin bileşimi olan sinyalleri kullanabilir. Böyle bir durumda “model %90 doğru” bilgisi tek başına, belirli bir hastanın neden yüksek risk aldığı sorusunu cevaplamaz.
Bu nedenle makale, yorumlanabilirlik yöntemlerinin klinisyenlere modelin davranışını inceleme imkânı vermesini önemli görür; ancak mevcut iAI araçlarının da sınırlılıklarını özellikle belirtir. Özellikle class activation map ve saliency map gibi görsel yöntemler, geniş veya klinik olarak belirsiz alanları işaretleyebilir. Yazarlar mevcut yöntemlerin daha yeni yaklaşımlarla birleştirilmesinin güven oluşturma açısından gerekli olabileceği sonucuna varır.
7. Güvenilirlik yalnızca modelin içinde çözülmez
Palenski ve arkadaşlarının 2024 tarihli “How AI Works: Reconfiguring Lifelong Learning” çalışması, AI’yı yalnızca teknik bir araç olarak görmenin eksik kalabileceğini savunur. İnceledikleri 49 çalışmayı üç gruba ayırırlar: AI’nın insanı daha verimli hale getiren bir araç olarak görüldüğü “working AI”, AI’nın bir meslektaş veya iş birliği aktörü gibi ele alındığı “working with AI” ve AI’nın insanlar, roller ve bağlamlarla birlikte sistemi yeniden şekillendirdiği “reconfiguring AI”.
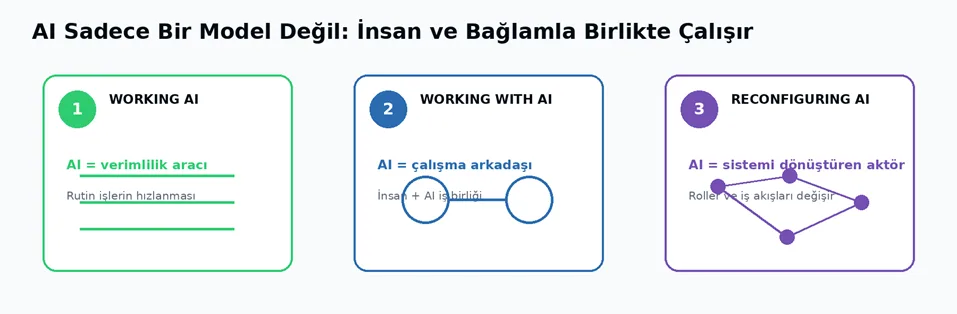
Şekil 6. AI-insan ilişkisinin üç farklı çerçevesi. Kaynak: Palenski et al. (2024); yeniden çizim.
Bu çerçeve güvenilirlik açısından da önemlidir. Bir model teknik olarak güçlü olsa bile yanlış iş akışına yerleştirilebilir, kullanıcıya aşırı otorite hissi verebilir veya sorumluluk dağılımını belirsizleştirebilir. Dolayısıyla güvenilir AI yalnızca “iyi model” değil; doğru veri, doğru arayüz, doğru kullanım rolü ve doğru insan denetimiyle tasarlanmış bir sosyoteknik sistemdir.
8. Bir AI sistemini değerlendirirken sorulacak 8 soru
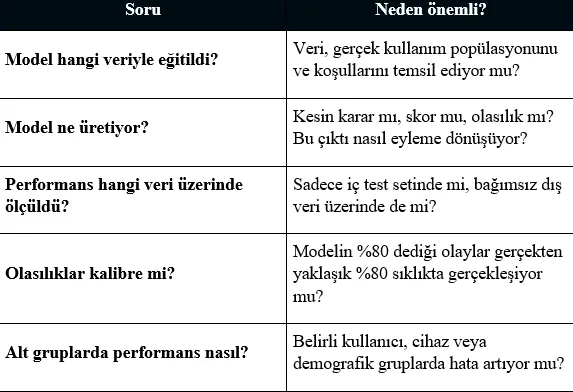
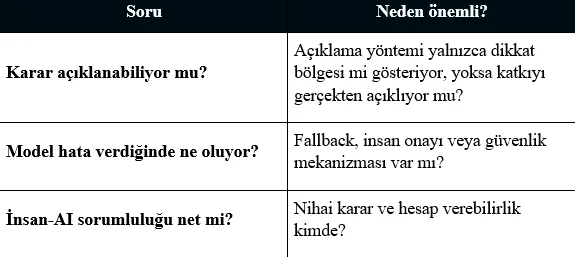
Sonuç: Güven, “AI doğru mu?” sorusundan daha büyüktür
Yapay zekâ veriden örüntü öğrenir, öğrendiği parametrelerle yeni girdiler için tahmin üretir ve bu tahminler belirli kurallarla karar veya eyleme dönüşür. Özellikle derin öğrenme modellerinde ara temsiller çok karmaşık olabildiği için kararın nedenini insan dilinde açıklamak her zaman kolay değildir. Bu yüzden açıklanabilirlik ve yorumlanabilirlik, performans kadar önemli hale gelir.
Bir AI sisteminin güvenilirliği yalnızca doğruluk yüzdesiyle ölçülemez. Veri kalitesi, dış doğrulama, kalibrasyon, alt grup performansı, dayanıklılık, açıklanabilirlik ve insan denetimi birlikte değerlendirilmelidir. Son aşamada soru “AI insandan daha iyi mi?” değil; “Bu görevde hangi kararı AI vermeli, hangisini insan vermeli ve hangisini birlikte vermeliyiz?” olmalıdır.
Kaynaklar
1. An, S., Teo, K., McConnell, M. V., Marshall, J., Galloway, C., & Squirrell, D. (2025). AI explainability in oculomics: How it works, its role in establishing trust, and what still needs to be addressed. Progress in Retinal and Eye Research, 106, 101352. DOI: 10.1016/j.preteyeres.2025.101352.
2. Palenski, T., Hills, L., Unnikrishnan, S., & Eynon, R. (2024). How AI Works: Reconfiguring Lifelong Learning. Postdigital Science and Education, 6, 1216–1239. DOI: 10.1007/s42438-024-00496-y.
3. Delipetrev, B., Tsinaraki, C., & Kostić, U. (2020). Historical Evolution of Artificial Intelligence. European Commission Joint Research Centre, EUR 30221 EN. DOI: 10.2760/801580.
4. An Idiots Guide to AI & Robotics. Temel kavramlar için giriş niteliğinde rehber; yapay sinir ağları, ajanlar, arama yöntemleri, uzman sistemler ve öğrenme türleri bölümleri kullanılmıştır.
İlgili Yazılar
Yenilenebilir Enerji Yatırımında Hassasiyet Analizi Neden Zorunlu Hale Geliyor?
Tek bir baz senaryo yatırımın kırılganlığını göstermez. Hassasiyet analizi üretim, maliyet, fiyat ve finansman değişkenlerinin IRR, NPV ve DSCR üzerindeki etkisini sistematik biçimde ölçerek kararın hangi koşullarda değiştiğini ortaya çıkarır.
GES Tasarımında Arazi Verimliliği: MW Başına Kaç Metrekare Gerçekten Gerekli?
GES için MW başına sabit bir arazi katsayısı yoktur. Panel verimi, tilt, sıra aralığı, tracker, topoğrafya, yollar, trafo alanları ve güvenlik mesafeleri aynı parselde kurulabilecek MWp ve üretilebilecek MWh miktarını değiştirir.
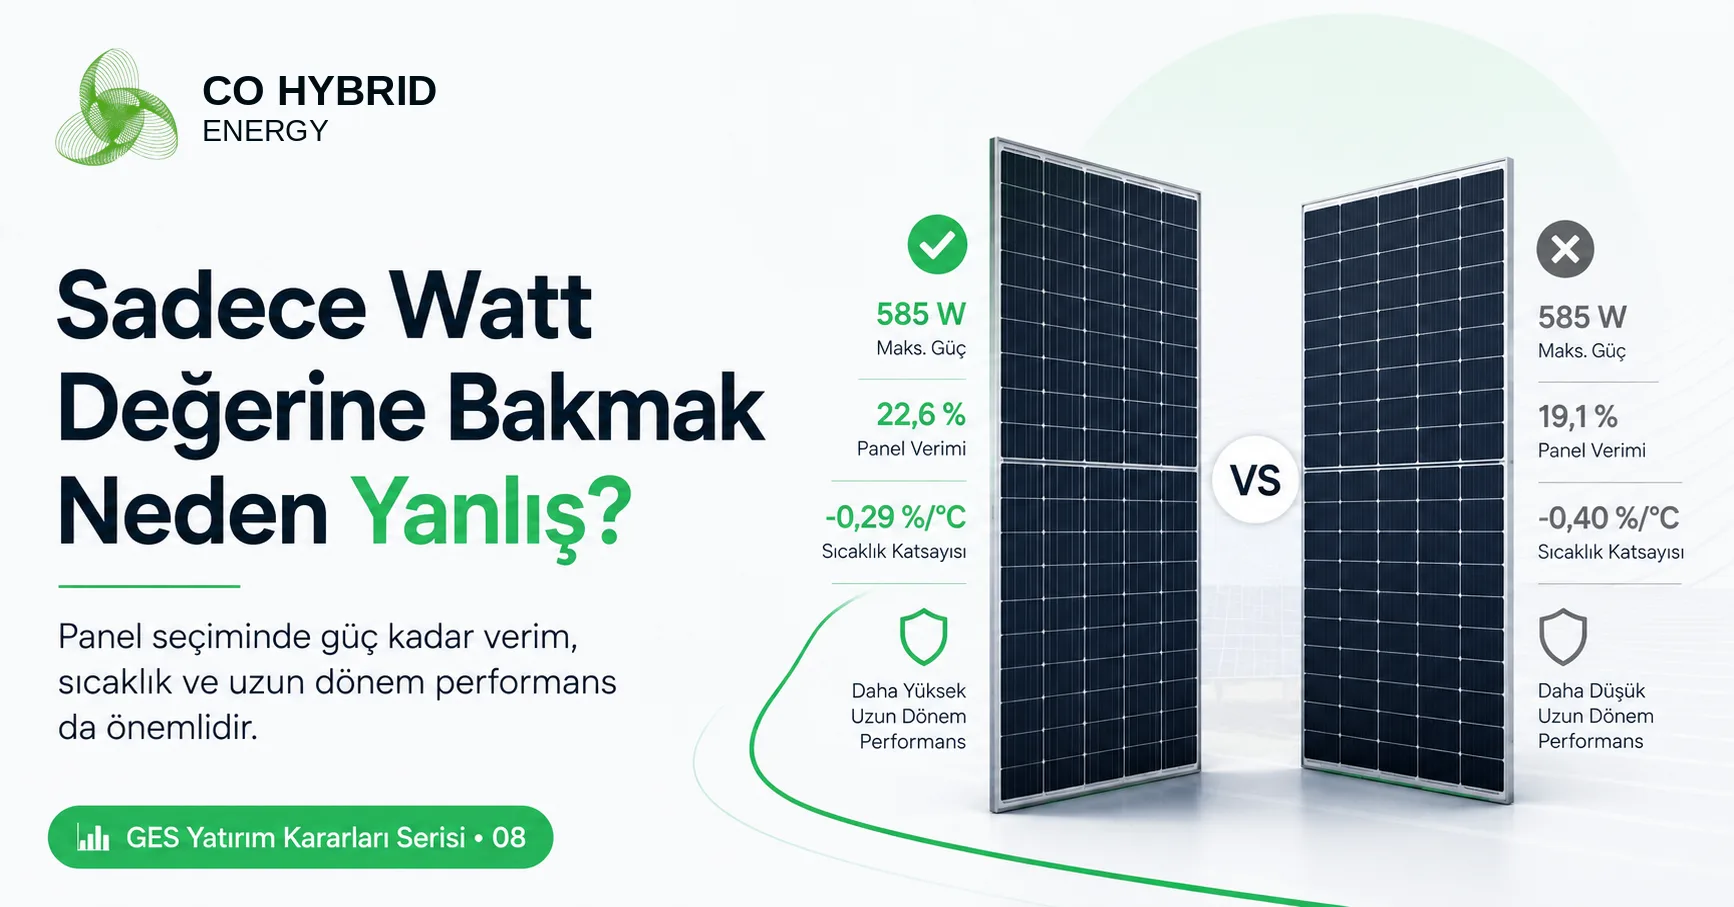
İki Farklı Panel Arasında Karar Verirken Sadece Watt Değerine Bakmak Neden Yanlış?
Kısa Özet Panelin nominal watt değeri önemli fakat sistem seviyesinde karar vermek için yetersizdir. Verimlilik, fiziksel alan, sıcaklık davranışı, bifacial performans, degradasyon, güvenilirlik ve BOS maliyetleri aynı yatırım analizinde birlikte değerlendirilmelidir.